lith: Die Laufzeit unter unseren Go-Apps
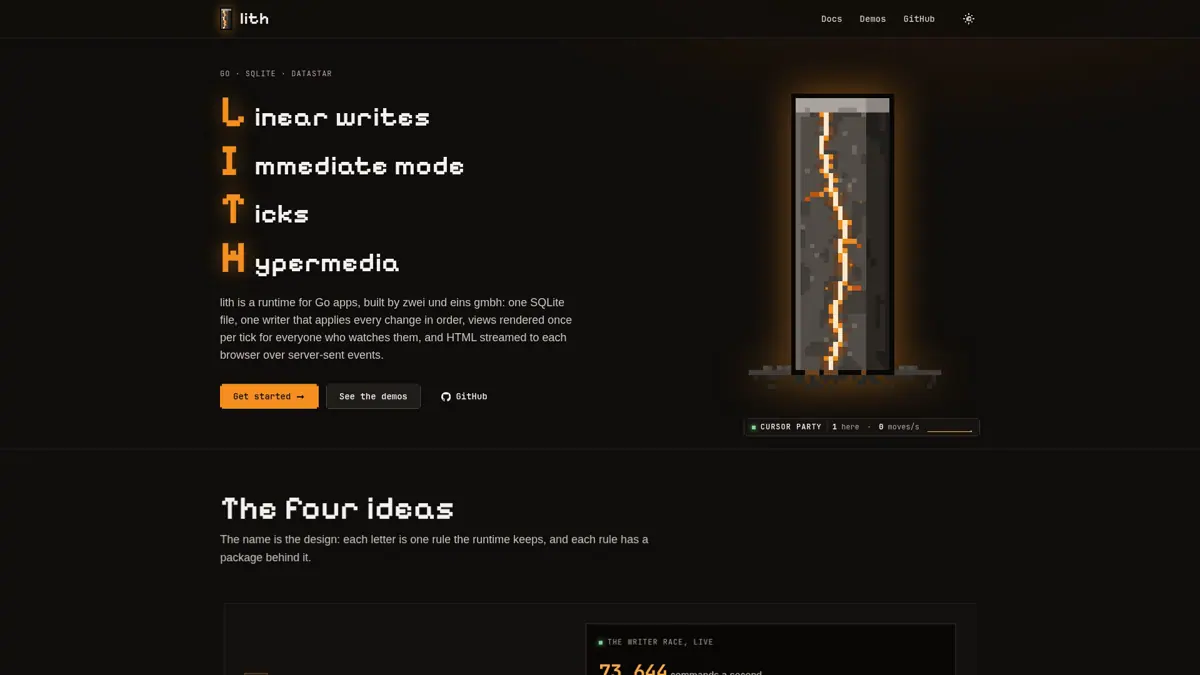
lith ist die Open-Source-Laufzeit unserer Multiplayer-Apps in Go, SQLite und Datastar: ein Writer, ein Render pro Tick, komprimierte HTML-Streams, gemessen.
- Hypermedia für gewöhnliche Apps
- Dieselbe Architektur, in jeder App von Hand gebaut
- Linear writes: ein Writer, gebündelte Transaktionen
- Immediate mode: Die Ansicht ist eine Funktion des Zustands
- Ticks: ein Render pro Ansicht und Tick
- Hypermedia: ein Kompressor pro Stream, zstd oder Brotli
- Befunde zu SQLite, Chromium und Brotli
- Was lith der App überlässt
- Ein erster Befehl und eine Live-Ansicht
- Einsatzbereich: ein Prozess, ein Host
- Wo lith läuft
- Vorbilder und Bausteine
- Einschränkungen
- Ein Projekt beginnen
lith ist die Laufzeit unter unseren Go-Apps auf SQLite und Datastar. Seiten werden auf dem Server gerendert und bleiben über einen Stream pro Tab live, so braucht Multiplayer keinen eigenen Code.
- Linear writes: Ein Writer führt alle Befehle der Reihe nach aus, gebündelt in Transaktionen. Allein committet er auf einem VPS für 10 Dollar im Monat 80’530 Befehle pro Sekunde (synthetisch, ohne HTTP).
- Immediate mode: Eine Seite ist eine Funktion der Datenbank; kein Zustand im Browser muss mit dem Server abgeglichen werden.
- Ticks: Eine geänderte Ansicht rendert einmal pro Tick für alle, die sie offen haben. 200 Tabs auf einem Board brauchen 55% eines Kerns (im Prozess).
- Hypermedia: HTML geht über Server-Sent Events hinaus, pro Stream komprimiert. Ein wiederholter Frame von 142 KB kostet 2.2 KB, und zstd braucht etwa die Hälfte der CPU von Brotli.
Open Source (MIT), reines Go, ein Binary ohne cgo. lith besitzt nur die Laufzeit: Routen, Templates und das Domänenmodell bleiben bei der App.
Hypermedia für gewöhnliche Apps
In einer Hypermedia-App schickt der Server HTML, nicht JSON. Im Browser läuft Datastar, eine kleine Bibliothek, die jedes Stück HTML vom Server anhand der Element-IDs in die Seite morpht. Es gibt keine JSON-API und keine Kopie des Zustands im Browser, die mit dem Server Schritt halten muss: Die Seite zeigt, was der Server zuletzt gerendert hat.
Geschäftssoftware besteht meist aus Formularen, Listen, Tabellen und Admin-Masken, und daraus bestehen auch die Apps, die wir auf diese Weise gebaut haben: diese Website, Starbase, das Kanban-Board, Tickit und Libretto. Für sie hat das Modell gegenüber einer Single-Page-App drei Vorteile:
- Eine Render-Funktion pro Ansicht ersetzt drei Dinge, die eine Single-Page-App synchron halten muss: die API, die die Daten liefert, den Store im Browser, der sie hält, und die Templates im Browser, die sie zeichnen.
- Ein Formular schickt einen Befehl. Der Server prüft ihn, schreibt ihn und antwortet mit einem leeren
204. Die Ansicht wird aus der Datenbank neu gerendert, und das neue HTML kommt über den Stream in die Seite. - Multiplayer ist eingebaut: Live-Updates für mehrere Leute kommen aus demselben Code. Jede Ansicht ist schon eine Funktion der Datenbank: Ändert ein Befehl eine Zeile, bekommt jeder offene Tab, der sie zeigt, die neue Fassung. Einen zweiten Weg für "jemand anderes hat das geändert" schreibt niemand.
Was das auf einem langsamen Handy beim Laden, bei der Datenmenge und beim JavaScript ausmacht, steht in unserem Vergleich eines Next.js-Chatbots mit seinem Nachbau in Hypermedia, für ein gemeinsames Board in unserem Vergleich des Kanban-Boards mit PLANKA.
Dieselbe Architektur, in jeder App von Hand gebaut
Unsere eigenen Apps und mehrere Kundenprojekte laufen auf Go, SQLite und Datastar. Als wir sie nebeneinandergelegt haben, hatte jede dieselbe Laufzeit von Hand gebaut, jede auf ihre Art: einen Writer für SQLite, etwas, das entscheidet, wann gerendert wird, und pro Tab einen Stream mit Server-Sent Events.
Im Einzelnen: Einige Apps serialisierten ihre Schreibzugriffe, indem sie dem Datenbank-Pool eine einzige Verbindung gaben (SetMaxOpenConns(1)), ohne Queue, ohne Bündeln, und Lesezugriffe warteten hinter der Schreibverbindung. Eine App committete pro Befehl ein Event und seine Projektion in zwei verschiedene Datenbankdateien. Die meisten renderten jede Ansicht bei jeder Änderung für jeden Stream neu. Jeder Stream hielt seinen eigenen Kompressor mit Brotlis Standardfenster, in einer App 9.9 MiB pro offenem Tab. Und in mehreren Projekten beschrieb die Dokumentation einen einzigen Writer, den der Code nicht hatte.
lith ist diese Laufzeit, einmal geschrieben, als Go-Bibliothek. Der Name zählt ihre vier Teile auf: Linear writes, Immediate mode, Ticks und Hypermedia. Die aktuelle Version ist v0.5.0.
Linear writes: ein Writer, gebündelte Transaktionen
SQLite lässt jeweils eine Verbindung schreiben. Schreibt jeder Request aus seiner eigenen Goroutine, stehen alle für das Lock an, und nach dem Busy-Timeout scheitern einige mit SQLITE_BUSY. lith gibt die Schreibverbindung einer einzigen Goroutine, dem Writer. Jede Änderung ist ein Befehl, und der Writer wendet die Befehle in der Reihenfolge an, in der sie ankommen. Während eine Transaktion committet, warten die nächsten Befehle, und der Writer nimmt bis zu 512 davon in eine BEGIN IMMEDIATE-Transaktion, jeden in einem eigenen Savepoint. Scheitert ein Befehl, nimmt er nur seinen Savepoint zurück. Eine optimistische Retry-Schleife gibt es nicht: Jeder Befehl sieht alle Befehle vor ihm.
Das Bündeln macht synchronous=FULL bezahlbar, bei dem jeder Commit auf die Disk wartet. Ein Produzent allein schafft auf unserer Entwicklungsmaschine (Intel i5-13500) 526 Befehle pro Sekunde, mit einem fsync von 1.9 ms für jeden. Fünfzig Produzenten teilen sich jeden fsync, 25 Befehle auf einmal, und kommen 25-mal so weit. Bei 200 Produzenten nimmt eine Transaktion 122 Befehle, und der Writer committet 34’893 pro Sekunde. Einstellen muss man dafür nichts: Unter Last teilen sich mehr Befehle jeden Commit.
Befehle pro Sekunde, Writer allein
Auf dem VPS, der die Website von lith ausliefert, vier vCPUs eines AMD EPYC und 4 GB Speicher für etwa 10 Dollar im Monat, committet derselbe Benchmark mit synchronous=NORMAL 80’530 Befehle pro Sekunde bei 200 Produzenten, 108 pro Transaktion. Mit NORMAL bremst die CPU den Writer, etwa 13 µs pro Befehl. Der eigene Code des Writers (Queue, Savepoints, Statement-Cache) macht im Profil weniger als 2% aus; den Rest teilen sich SQLite, database/sql mit dem Treiber und der Garbage Collector.
NORMAL ist die Voreinstellung von lith, und es hat Kleingedrucktes. Stürzt der Prozess ab, geht nichts verloren. Ein Stromausfall oder ein Absturz des Kernels kann aber bis zu etwa 35 Sekunden bestätigter Commits rückgängig machen, mit dem Writeback, den Linux standardmässig verwendet. Wo das zählt, stellt eine App FULL ein und zahlt einen fsync pro Batch: Auf dem VPS, dessen fsync etwa 7 ms dauert, sind das 14’480 Befehle pro Sekunde bei 200 Produzenten. Auf der Entwicklungsmaschine, neben einem Board mit 200 offenen Streams, committet ein Befehl mit NORMAL in 0.3 bis 0.5 ms (p50) und mit FULL in 2.7 bis 5.5 ms. Das p99 lag mit FULL bei 11 ms und mit NORMAL bei 29 ms, solange die Streams zstd verwendeten, mit Brotli bei 7.4 und 12 ms. Diese Ausreisser gehören zum geteilten SSD-Pool des Hosts: Mit NORMAL reichten sie je nach Lauf von 1.4 bis 49 ms (synchronous FULL against NORMAL).
Immediate mode: Die Ansicht ist eine Funktion des Zustands
Ein Bereich einer Seite ist view = f(state): eine Render-Funktion, die aus der Datenbank liest und HTML zurückgibt. Sie rendert die Ansicht ganz, und Datastar morpht sie in die Seite. Der Server führt kein Diff darüber, was der Browser hat, und der Browser hat keinen Reducer. Nichts im Browser sagt voraus, was der Server tun wird, also gibt es kein optimistisches Update, das man zurücknehmen müsste, wenn der Server ablehnt. Der Name stammt von den Immediate-Mode-UIs, die den ganzen Bildschirm bei jedem Frame aus dem Zustand zeichnen.
Der Preis sind Bytes. Wer ganze Ansichten rendert, schickt dasselbe HTML immer wieder: Das gemeinsame Board in unseren Benchmarks hat 142’067 Bytes pro Frame. Die Kompression holt das meiste zurück, weil jeder Stream ein Fenster über seine eigene Vergangenheit hält und ein Frame, der den letzten bis auf eine Karte wiederholt, auf ihn verweist. Auf dem VPS ging dieses Board mit 2’188 Bytes pro Frame hinaus, 65:1.
Daraus folgt eine Regel: Ein GET schreibt nie. Keine Session-Zeile, kein Besuchszähler. Crawler vervielfachen jeden Schreibzugriff, den ein GET macht.
Ticks: ein Render pro Ansicht und Tick
Wann gerendert wird, entscheidet der Hub, nicht der Request. Ein Commit berührt Topics, die Topics markieren Ansichten als veraltet, und alle 50 ms (der Standard-Tick) rendert jede veraltete Ansicht einmal, in einer Lesetransaktion, für jeden Stream, der sie anschaut. Egal wie viele Commits in einem Tick landen: Jede geänderte Ansicht rendert einmal.
Unser Benchmark dafür ist der Lauf des Kanban-Boards mit 200 Tabs, ohne HTTP: 200 Streams auf einem Board mit 200 Karten, während 200 Produzenten 800 Befehle pro Sekunde schicken, sodass sich das Board in jedem Tick ändert. Auf der Entwicklungsmaschine lief er mit 19.8 Ticks pro Sekunde und 1.00 Render pro Tick, schickte etwa 3’960 Frames pro Sekunde und liess keinen fallen. Auf dem VPS hielt der ganze Lauf 55% eines Kerns beschäftigt, mit einem Tick-p95 von 1.1 ms.
Ein Stream behält pro Ansicht nur den neuesten Frame. Ein langsamer Client überspringt also Frames und hält niemanden auf. Eine Ansicht rendert ausserdem nicht, solange jeder Stream, der sie anschaut, noch einen Frame wartend hat. Wir haben das mit 50 Tabs gemessen, deren Clients nicht mehr lasen, jeder mit einer eigenen Ansicht von 34 KB, die sich in jedem Tick ändert: Ohne diese Regel brauchte der Hub etwa 1.5 Kerne, mit ihr 0.03 bis 0.05. Streams, die mithalten, kosten gleich viel wie vorher.
Ein gemeinsames Board, gemessen
Eine kleine Multiplayer-Demo: Alle, die diesen Beitrag gerade lesen, sehen dasselbe Board. Ein Klick färbt ein Feld in der Farbe Ihres Tabs: Die Seite schickt einen Befehl, der Server gibt ihn dem Writer und antwortet mit 204, sobald er committet ist. Das Feld färbt sich erst mit dem nächsten Frame über den Stream, bei Ihnen wie bei allen anderen. Das Board ist eine einzige Ansicht für alle Tabs und rendert pro Tick höchstens einmal. Nach zehn Minuten ist ein Feld wieder leer.
Bei «200 Befehle auf einmal» gibt der Server selbst dem Writer 200 Befehle gleichzeitig, aus 200 Goroutinen, jeden für ein zufälliges Feld in Ihrer Farbe; über HTTP geht dafür ein einziger Request. Darunter steht, in wie vielen Transaktionen sie landen und wie oft das Board dafür rendert.
Tabs, die dieses Board gerade sehen: …
- Ihre Farbe
- …
- Befehle
- …
- Transaktionen
- …
- BEGIN bis COMMIT
- …
- Renders des Boards
- …
- Frames an diesen Tab
- …
- Der Frame: HTML → Leitung
- …
- Bis zur Antwort 204
- …
- Bis zum Frame
- …
Klicken Sie auf ein Feld. Die Zahlen oben gehören dann zu Ihrem Klick.
Hypermedia: ein Kompressor pro Stream, zstd oder Brotli
Frames gehen als Datastar-Events über Server-Sent Events hinaus, einmal formatiert und an jeden Stream als dieselben Bytes geschrieben. Jeder Stream komprimiert für sich, mit einem Fenster über den ganzen Stream, sodass ein Frame, der den vorigen wiederholt, auf ihn verweist. Ganze Ansichten zu rendern ist nur deshalb bezahlbar. lith wählt den Encoder pro Stream: zstd, wenn der Browser es annimmt, sonst Brotli, sonst gzip.
zstd gegen Brotli auf dem gemeinsamen Board
Dasselbe Board mit 200 Streams, im Prozess ohne HTTP und mit synchronous=FULL, Median aus sechs Läufen auf der Entwicklungsmaschine:
| 200 Streams, ein Board, synchronous=FULL | zstd, schnellste Stufe | Brotli, Qualität 4 |
|---|---|---|
| CPU, belegte Kerne | 1.82 | 3.42 |
| Bytes pro Frame auf der Leitung | 2’217 | 854 |
| Heap pro Stream | 1.68 MiB | 1.56 MiB |
| Tick p99 | 4.1 ms | 2.1 ms |
zstd schickt pro Frame 2.6-mal so viele Bytes wie Brotli und braucht dafür etwa die Hälfte der CPU. Über HTTP, mit einem Lasttool auf derselben Maschine, zeigte das Kanban-Board mit 200 Tabs auf lith v0.2.0 denselben Tausch: 2.7 Kerne und 3’162 Bytes pro Frame mit zstd, 5.2 Kerne und 1’010 Bytes mit Brotli (benchmarks/RESULTS.md des Kanban-Boards).
Das Fenster muss den vorigen Frame erreichen
Der Kompressor eines Streams merkt sich die zuletzt gesendeten Bytes, so weit sein Fenster reicht. Ändert sich auf dem Board eine Karte, ist der neue Frame der vorige bis auf diese Karte, und der Kompressor kann das in wenigen Bytes sagen: «wiederhole, was vor 142 KB kam, und dann diese neuen Bytes». Das geht nur, solange der vorige Frame noch ins Fenster passt. Ist das Fenster kleiner als der Frame, ist der Anfang des vorigen Frames schon herausgefallen, und der Kompressor muss den Frame fast so schicken, als wäre er der erste.
Mit Brotli in Qualität 4 braucht derselbe Frame des 142-KB-Boards bei einem Fenster von 217 (128 KiB) 9’849 Bytes, bei 218 (256 KiB) aber nur 95 Bytes: 142’067 Bytes HTML in 95, etwa 1’500-mal kleiner. zstd fällt weniger steil: 10’831 Bytes bei 217, 2’703 bei 218, 1’471 bei 219 und 794 bei 220. gzip mit seinem Fenster von 32 KiB braucht 13’169 Bytes. Das Speicherbudget von lith gibt deshalb jedem Stream das kleinste Fenster, das seinen grössten Frame hält, plus ein Sechzehntel.
Speicher pro offenem Tab
Ein offener Tab hält seinen Encoder, solange er offen bleibt. Der Speicher pro Stream entscheidet also, wie viele Tabs ein Server halten kann. Datastars Go-SDK behält mit WithBrotli ohne WithBrotliLGWin das Fenster von 4 MiB, das Brotli als Standard hat: 9.9 MiB Heap pro Stream bei Qualität 5. Mal 1’000 Streams hielten die Encoder dort etwa 9.7 GiB, mit der Voreinstellung von lith (zstd in der schnellsten Stufe bei 219) 1.6 GiB und mit ZstdLowMemory 1.0 GiB. Das rechnet nur den Heap der Encoder hoch, nicht einen Server mit 1’000 HTTP-Verbindungen.
Hochgerechneter Encoder-Heap für 1’000 Streams
Schwankungen von zstd unter Hintergrundlast
Die CPU-Werte von zstd hängen davon ab, was die Maschine sonst tut. Auf der Entwicklungsmaschine haben wir vier Läufe mit zstd auf dem Board abgewechselt, mit und ohne zwölf Endlosschleifen mit niedriger Priorität (nice -n 19 yes) auf denselben Kernen. Mit den Schleifen brauchte der Prozess 0.80 und 0.86 Kerne bei einem Tick-p50 von 1.25 ms. Ohne sie brauchte er 1.50 und 1.90 Kerne, bei 1.7 und 4.1 ms.
Zwischen den Ticks lässt der zstd-Prozess die meisten seiner Kerne leer laufen, und Kerne, die immer wieder in den Leerlauf fallen, brauchen für dieselbe Arbeit länger. Das liegt am Energiemanagement der CPU (intel_pstate im Modus powersave) oder am Scheduler, der Threads auf leere Kerne verschiebt; unsere Läufe trennen die beiden nicht. Brotli hält selbst drei Kerne beschäftigt und schwankt weniger. Beim Kanban-Board zeigt sich dasselbe am Takt: Seine Kerne liefen mit zstd im Schnitt mit 1.9 bis 2.8 GHz, mit Brotli mit 2.4 bis 3.4 GHz.
Voreinstellung der Kompression: zstd bei 219
Für die meisten Apps ist der Speicher pro offenem Tab die Grenze, und zstd braucht etwa die Hälfte der CPU von Brotli. Die Voreinstellung von lith ist deshalb zstd in der schnellsten Stufe bei 219, etwa 1.65 MiB pro Stream. Brotli bedient Browser ohne zstd, darunter Safari vor 26.3. Nur zstd-Streams können ausserdem schlafen gehen und ihren Encoder abgeben, solange ein Tab ruht; warum, steht im nächsten Abschnitt.
Der Stream dieses Tabs
Solange dieser Kasten zu sehen ist, schickt der Server ihn einmal pro Sekunde neu, über den Stream, den dieser Tab offen hält. Jeder Frame wiederholt den letzten bis auf ein paar Zahlen; die Zahlen unten sind die des Streams selbst, vor und nach der Kompression.
- Kompression
- …
- Fenster
- …
- Bisher gesendet
- …
- Verhältnis
- …
- Letzter Frame
- …
Verbindet …
Befunde zu SQLite, Chromium und Brotli
- Statements neu vorbereiten. Der SQLite-Treiber in reinem Go (modernc.org/sqlite) bereitet ein Statement bei jedem Aufruf neu vor. Beim Kanban-Board kostete das 41% der CPU des Writers. Seit der Writer jedes Statement einmal vorbereitet und behält, schafft das Board etwa 13’800 statt 10’000 verschobene Karten pro Sekunde. Der Writer von lith behält die 512 zuletzt benutzten Statements, jede Leseverbindung 128.
- Ein gebundenes
LIMIT ?hebelt den Cache aus. SQLite 3.53 liest ein gebundenesLIMITbeim Vorbereiten und bereitet das Statement neu vor, sobald der Parameter gebunden wird, und das tut der Treiber bei jedem Aufruf. MitLIMIT 20direkt im SQL machte der Cache eine Leseabfrage 28% schneller (21.6 statt 29.8 µs), mitLIMIT ?nur 17% (25.2 statt 30.4 µs). Die Messung steht in bench/RESULTS.md, Read pool statement cache. - Chromium verwirft einen zweiten Brotli-Stream. Ein Stream, der schlafen geht, gibt seinen Encoder ab und beginnt beim Aufwachen einen neuen komprimierten Abschnitt. Chromium 154 dekodiert einen zstd-Body aus mehreren Frames Event für Event. Folgt in einem Brotli-Body ein zweiter Brotli-Stream auf den ersten, dekodiert Chromium den ersten und verwirft den zweiten ohne Fehlermeldung. Deshalb schlafen nur zstd-Streams. Nach 30 s Ruhe hält ein Tab dann 0.106 statt 0.640 MiB, für etwa 45 KB mehr auf der Leitung pro Tab und Stunde. Der Test ist sse/chromium_test.go, die Zahlen stehen auf der Seite zur Hibernation der Dokumentation.
- Brotli braucht Flushes innerhalb eines Frames. Ohne Flush alle 16 KiB (Qualität 3) oder 32 KiB (Qualität 4) verlängert Brotli eine Kopie in den nächsten Eingabeblock, ohne ihn zu hashen, und verliert nach einer Änderung in einem grossen Frame den vorigen Frame aus dem Blick. Ein Board mit 230 KB brauchte bei Qualität 3 und 218 3’173 Bytes pro Frame; mit den Flushes sind es 259 (Large frames and brotli's flushes, Changelog von v0.2.0).
Was lith der App überlässt
lith besitzt die Laufzeit und nichts darüber. Es hat keinen Router: Routen bleiben bei net/http. Es hat keine Template-Engine: Das HTML kommt aus templ. Es hat kein Domänenmodell: Jede App behält ihre eigenen Seiten, Tabellen und Befehle.
Ein erster Befehl und eine Live-Ansicht
Eine Funktion auf lith besteht aus einem Befehl, einem Handler und einer Ansicht, verbunden durch ein Topic. Das ist der gemeinsame Zähler von der Seite The first command and view der Dokumentation, gekürzt; dort kommen Validierung, die Abfragefunktion, die templ-Komponente und die Seite dazu.
// A command: Apply runs in the writer's batch, in a savepoint.
type Add struct{ N int }

func (c Add) Apply(tx *writer.Tx) error {
	if _, err := tx.Exec(`UPDATE counter SET count = count + ? WHERE id = 1`, c.N); err != nil {
		return err
	}
	tx.Touch("counter") // the topic: views on it render in the next tick
	return nil
}

// The handler waits for the commit and answers 204.
err := s.w.Do(r.Context(), Add{N: 1})

// A view: its key, its topics, and a render from the database.
live.View{
	Key:    "counter",
	Topics: []string{"counter"},
	Render: func(ctx context.Context, tx *sql.Tx) (any, error) {
		var n int
		if err := tx.QueryRowContext(ctx, `SELECT count FROM counter WHERE id = 1`).Scan(&n); err != nil {
			return nil, err
		}
		return sse.PatchElements([]byte(fmt.Sprintf(`<p id="counter">%d</p>`, n))), nil
	},
}
Touch nennt, was sich geändert hat. Nach dem Commit rendert jede Ansicht, die das Topic aufführt, im nächsten Tick einmal, und derselbe Frame geht an jeden Tab, der sie anschaut, auch an den, der geklickt hat. Das Gästebuch der Vorlage ergänzt eine Op-ID pro Aktion und eine Ansicht pro Tab, die das Ergebnis der Aktion zurückbringt.
Einsatzbereich: ein Prozess, ein Host
- Ein Prozess pro Datenbank. Eine lith-App ist ein Binary, das seinen Zustand in einer SQLite-Datei hält (Deploying). Der Writer hält die einzige Schreibverbindung der Datei, und der Hub erfährt von Commits über diesen Writer, im selben Prozess. Für mehrere Prozesse auf einer Datenbank oder einen Hub, den sich Prozesse teilen, hat lith keine Lösung. Bei einem Deploy endet der alte Prozess, und die Seiten verbinden sich mit dem nächsten.
- Keine horizontale Skalierung, kein Failover. lith läuft auf einem Host: Es verteilt eine App nicht auf mehrere Server und hat kein Failover. Die Replik von Litestream dient der Wiederherstellung, sie ist kein zweiter Server, der übernimmt. Innerhalb eines Prozesses kann eine App, deren Konten keine Daten teilen, pro Konto eine eigene SQLite-Datei führen (One database per account).
- Backups und Migrationen gehören der App, mit den Werkzeugen von lith. Die App macht
VACUUM INTO-Kopien per Timer oder hängt das Modulbackupan, das Litestream einbettet, jeden Commit in einen S3-kompatiblen Speicher repliziert, täglich eine Replik zur Prüfung wiederherstellt und die Datenbank auf einer leeren Disk wiederherstellt, bevor sie öffnet (Backups). Migrationen sind nummerierte SQL-Dateien in der App;sqlite.Openwendet jene über deruser_versionder Datenbank an, jede in einer eigenen Transaktion, und ein älteres Binary weist eine neuere Datenbank ab (Migrations). - Grosse einzelne Schreibzugriffe. Der Writer führt einen Befehl nach dem anderen aus, also hält ein grosser Schreibzugriff alle anderen auf. Den Volltextindex über 45’000 Kommentare neu aufzubauen, hielt jeden Befehl 2.8 s auf, und die Seiten bekamen 2.9 s lang keinen Frame; ein Update derselben Tabelle in Befehlen zu 1’000 Zeilen hielt jeden anderen Befehl unter 45 ms (die Messungen, wie man solche Schreibzugriffe aufteilt).
- Die API vor 1.0. lith steht bei v0.5.0. Bis 1.0 darf ein Minor-Release die API ändern, und jeder Eintrag im Changelog sagt, was in einer App anzupassen ist (CHANGELOG.md).
Wo lith läuft
- 2und1.ch. Diese Website. Ihre SQLite-Datei hält den Ausgang des Kontaktformulars und das gemeinsame Board weiter oben, und die Live-Teile der Seite kommen über einen Stream. Beim Umzug auf lith sind 1’510 Zeilen handgeschriebenes Go weggefallen und 635 dazugekommen, und die Web-Tests laufen in 14 statt 107 Sekunden.
- Starbase, unsere Galerie von Datastar-Webkomponenten, läuft in Produktion auf lith. Mit 100 offenen Tabs hielt sie nach 20 Updates 162 MB statt 1.25 GB Speicher, im Ruhezustand 161 statt 438 MB.
- Das Kanban-Board aus unserem Vergleich mit PLANKA. Jener Artikel hat die Architektur gemessen, von Hand gebaut; lith ist dieselbe Architektur als Bibliothek. Auf lith committet das Board bei 200 Personen etwa 14’500 verschobene Karten pro Sekunde, und mit zstd braucht sein Server die Hälfte der CPU, die er mit Brotli braucht.
- Tickit haben wir auf lith neu aufgebaut, als Issue-Tracker mit Wiki für mehrere Leute gleichzeitig.
- Libretto, unsere Software für die Gesamtkosten eines Autos in der Schweiz, zieht auf lith um, ebenso Kundenprojekte.
Vorbilder und Bausteine
Die Überlegungen hinter lith stammen von Anders Murphy: aus seinen Artikeln und aus seinem Framework hyperlith. Von ihm haben wir das Bündeln mit einem Savepoint pro Befehl, und ZstdLowMemory ist die Einstellung von hyperlith. Tickit begann als Fork von northstar, und lith ist von beiden inspiriert. lith baut auf Datastar, auf modernc.org/sqlite (SQLite in reinem Go, deshalb baut alles mit CGO_ENABLED=0), auf klauspost/compress für zstd und auf andybalholm/brotli.
Einschränkungen
- Alle Zahlen stammen von einer Entwicklungsmaschine (Intel i5-13500, auf der auch andere Dienste laufen) und einem VPS, den wir mit anderen Kunden des Hosts teilen. Die Load zu jedem Lauf steht in den Ergebnissen, und die Werte von zstd bewegen sich mit ihr, wie oben beschrieben.
- Die meisten Benchmarks laufen im Prozess, ohne HTTP und ohne Netzwerk: Die Clients nehmen jeden Frame sofort ab. Die Zahlen des Kanban-Boards über HTTP stammen von einem Lasttool auf derselben Maschine wie der Server.
- Die Werte für 1’000 Tabs sind pro Stream gemessen und hochgerechnet.
- Die Benchmarks von lith stehen mit Bedingungen, Befehlen und Load in bench/RESULTS.md; der Encoder-Heap pro Stream, samt den 9.9 MiB des Datastar-SDK, auf der Seite zu den Encodern der Dokumentation; die Zahlen des Kanban-Boards über HTTP in dessen benchmarks/RESULTS.md. Die Werte für Starbase und diese Website stammen aus unseren eigenen Messungen beim Umzug auf lith und sind nirgends sonst veröffentlicht.
Ein Projekt beginnen
lith-new schreibt ein neues Projekt aus der Vorlage, einem kleinen Gästebuch, das jede Regel einmal befolgt: ein Befehl, eine geteilte Ansicht, eine Ansicht pro Tab aus SQLite und ein Button, der wartend aussieht, bis sein Frame ankommt. Dazu kommen Tests, CI, Dateien für systemd und Caddy, ein Deploy-Skript mit Rollback und ein Timer für Backups.
go run github.com/zweiundeins/lith/cmd/lith-new@latest ~/develop/guestbook example.com/acme/guestbook
cd ~/develop/guestbook && go mod tidy && go tool task test
Die Dokumentation steht auf lith.zweiundeins.gmbh, der Quellcode auf GitHub. Das Repository enthält auch skills/lith, das einem Coding-Agenten die Regeln, Rezepte und Zahlen der jeweiligen Version beibringt.