SPA vs. Hypermedia: Performance unter realen Bedingungen
Wir haben Vercels Next.js-KI-Chatbot als serverseitig gerenderte Hypermedia-App nachgebaut und beide auf einem Mittelklasse-Handy über langsames 4G gemessen.
- Methodik: Die Vercel-Referenz-App als Massstab
- Lighthouse-Scores: Die Kluft auf Mobilgeräten
- Was über die Leitung geht
- Visueller Beweis: Wohin die CPU-Zeit geht
- Streaming-Effizienz: SSE-Kompression
- Codebase- & Betriebskomplexität
- Die Wirtschaftlichkeit der Einfachheit
- Einschränkungen & Vorbehalte
- Wann was wählen
- Zusammenfassung
Wir haben eine KI-Chat-Anwendung mit Hypermedia-Architektur (HTML wird vom Server gesendet) entwickelt und unter schlechten Mobilfunkbedingungen mit dem Vercel AI SDK Chatbot verglichen, der Next.js-Referenz-App von Vercel (eine komplexe JavaScript-App, die im Browser läuft). Der einfachere Ansatz eliminiert das Blockieren des Main-Threads vollständig, ist 27× kleiner und erreicht 8.3× schneller Interaktivität als der gängige Ansatz. Die Zahlen vergleichen eine typische Next.js-App mit einer Hypermedia-App, bei simuliertem Slow 4G und gedrosselter CPU; eine SPA, die auf wenig JavaScript ausgelegt ist, würde schneller laden als die von Vercel. Der Unterschied zählt dort am meisten, wo es darauf ankommt: auf Smartphones mit langsamen Verbindungen und begrenztem Akku. Geringe Komplexität bringt aber noch weitere Vorteile: weniger Abhängigkeiten zu pflegen, einfachere Deployments und eine deutlich kleinere Angriffsfläche.
Update, Oktober 2026
Ein halbes Jahr später haben wir beide Apps neu gemessen. Unsere App läuft inzwischen auf php-via, unserem eigenen Echtzeit-Framework auf OpenSwoole, statt auf Mezzio. Die Zahlen zu Lighthouse, übertragenen Daten und Abhängigkeiten unten stammen vom Oktober 2026.
Die DevTools-Traces und der Abschnitt zum Streaming zeigen weiterhin die Messung vom Februar: Die Vercel-Demo lehnt automatisierte Browser an ihrer Chat-API inzwischen ab, deshalb liess sich ihre Chat-Seite nicht neu messen. Alle Zahlen vom Oktober stehen in den Rohdaten.
Methodik: Die Vercel-Referenz-App als Massstab
Wir haben unsere eigene PHP/Datastar-Hypermedia-Implementierung mit dem Vercel AI SDK Chatbot verglichen, der Referenzimplementierung von Vercel für einen KI-Chat mit Next.js, an der rund 80 Leute mitgearbeitet haben.
Was dieser Vergleich misst
Wir haben das Vercel AI SDK gewählt, weil es den Standardansatz repräsentiert, den die meisten Teams beim Aufbau eines KI-Chats mit Next.js verwenden würden. Der Vergleich zeigt, was typische Implementierungsentscheidungen ergeben: Das Vercel SDK wird gut gepflegt, ist weit verbreitet und folgt React/Next.js-Best-Practices.
Die schnellste mögliche SPA ist es nicht. Eine SPA, die von Anfang an auf wenig JavaScript ausgelegt ist, würde schneller laden; so eine haben wir nicht gebaut. Die Hypermedia-App haben wir selbst geschrieben, die Vercel-App haben wir so gemessen, wie Vercel sie veröffentlicht. Einen zweiten Vergleich, an einer App mit Drag and Drop, in der mehrere Leute gleichzeitig arbeiten, zeigt unser Kanban-Board im Vergleich mit PLANKA.
Beide Anwendungen implementieren dieselben Kernfunktionen: KI-Streaming in Echtzeit, Chat-Verlauf, Dokument-Artefakte und Authentifizierung. Die Testbedingungen waren identisch: Chromium 154 mit Lighthouse 13.5 im Oktober (Chrome 144 im Februar), Slow-4G-Netzwerksimulation (1.6 Mbps, 150 ms RTT) und 4-fache CPU-Drosselung zur Simulation von Mittelklasse-Mobilgeräten. Die Lighthouse-Werte sind der Median aus drei Läufen.
Lighthouse-Scores: Die Kluft auf Mobilgeräten
Auf dem Desktop mit schnellen Verbindungen schneiden beide Architekturen vergleichbar gut ab. Die echten Unterschiede zeigen sich unter eingeschränkten Bedingungen, genau in der Umgebung, in der der Grossteil der weltweiten Nutzer unterwegs ist.
Desktop (ohne Drosselung)
| Metrik | SPA | Hypermedia | Unterschied |
|---|---|---|---|
| Performance Score | 90 | 100 | ähnlich |
| First Contentful Paint | 0.32 s | 0.30 s | ~gleich |
| Largest Contentful Paint | 1.64 s | 0.30 s | 5.5× schneller |
| Total Blocking Time | 153 ms | 0 ms | deutlich besser |
| Time to Interactive | 1.64 s | 0.30 s | 5.5× schneller |
| Cumulative Layout Shift | 0 | 0 | gleich |
Mobile (Slow 4G + 4× CPU-Drosselung)
Hier werden die Auswirkungen von Architekturentscheidungen sichtbar. Das JavaScript-Bundle, das auf einem schnellen Desktop kaum auffällt, wird zum kritischen Engpass, wenn das Netz langsam und die CPU eingeschränkt ist.
| Metrik | SPA | Hypermedia | Unterschied |
|---|---|---|---|
| Performance Score | 52 | 100 | 1.9× mehr |
| First Contentful Paint | 1.12 s | 1.07 s | ~gleich |
| Largest Contentful Paint | 8.85 s | 1.07 s | 8.3× schneller |
| Total Blocking Time | 898 ms | 0 ms | eliminiert |
| Time to Interactive | 8.87 s | 1.07 s | 8.3× schneller |
| Speed Index | 4.05 s | 1.07 s | 3.8× schneller |
Die Total Blocking Time von 898 ms vs. 0 ms der SPA bedeutet, dass der Main-Thread fast eine volle Sekunde lang nur mit dem Parsen und Ausführen von JavaScript blockiert ist: eine Zeit, in der die Seite zwar sichtbar, aber nicht auf Eingaben reagiert. Die Hypermedia-Version eliminiert das Blockieren vollständig: ihr server-gerendertes HTML ist sofort nutzbar, sobald es ankommt.
Was über die Leitung geht
| Metrik | SPA | Hypermedia | Verhältnis |
|---|---|---|---|
| HTTP-Anfragen | 35 | 7 | 5× weniger |
| Übertragen (komprimiert) | 1.4 MB | 51.8 KB | 27× weniger |
| Ressourcen (unkomprimiert) | 5.0 MB | 231 KB | 22× weniger |
| JavaScript (übertragen) | 1.3 MB | 13.6 KB | 95× weniger |
Die 27-fache Reduktion der übertragenen Bytes schlägt sich direkt in schnelleren Ladezeiten bei langsamen Verbindungen nieder. Bei 1.6 Mbps dauert das Herunterladen von 1.4 MB rund 7 Sekunden, bevor der Browser überhaupt mit dem Parsen beginnen kann. 51.8 KB dauern etwa eine Viertelsekunde.
Visueller Beweis: Wohin die CPU-Zeit geht
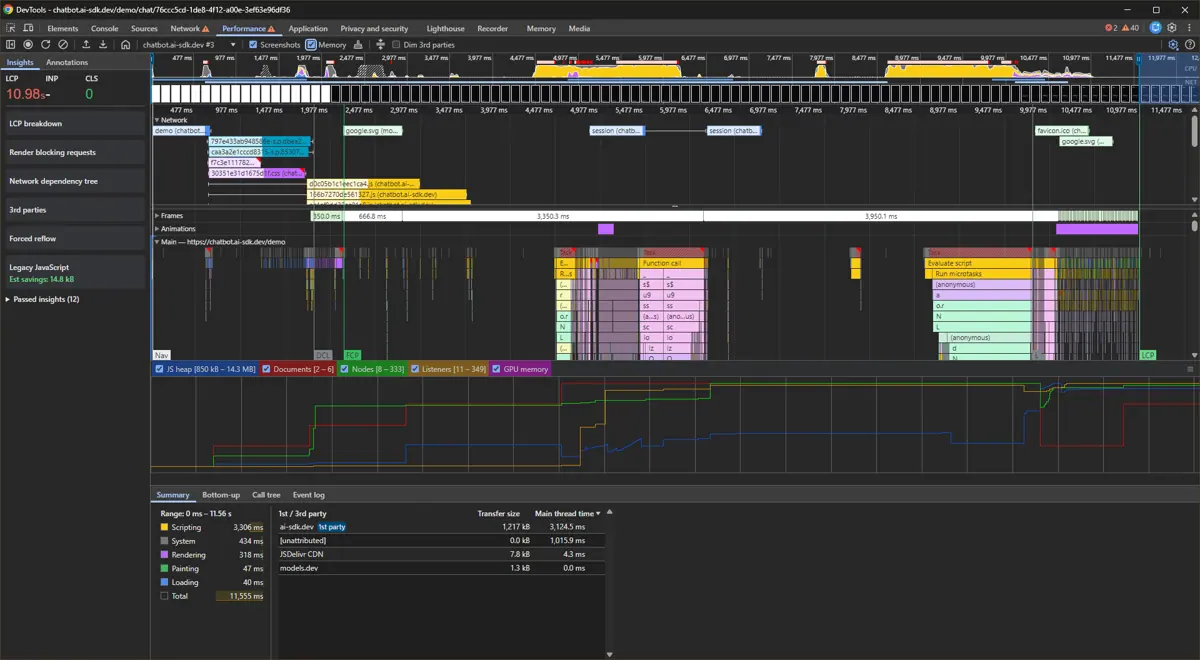
Performance-Profiling während tatsächlicher Seitenladevorgänge und Chat-Interaktionen zeigt, wie jede Architektur CPU-Ressourcen nutzt. Die Flamegraphen unten zeigen Chrome-DevTools-Performance-Traces unter identischen Bedingungen: Slow-4G-Netzwerkdrosselung und 4-fache CPU-Verlangsamung. Dieser Abschnitt zeigt die Messung vom Februar.
- Scripting: JavaScript-Ausführung
- Rendering: Style-/Layout-Berechnung
- Painting: Pixel auf dem Bildschirm
- System: Browser-Internas
- Loading: Netzwerkaktivität
- Idle: Verfügbar für Nutzereingaben
- Memory: JS-Heap (unteres Diagramm)
Vergleich beim Seitenladen
Schieberegler ziehen, um SPA (links) vs. Hypermedia (rechts) zu vergleichen
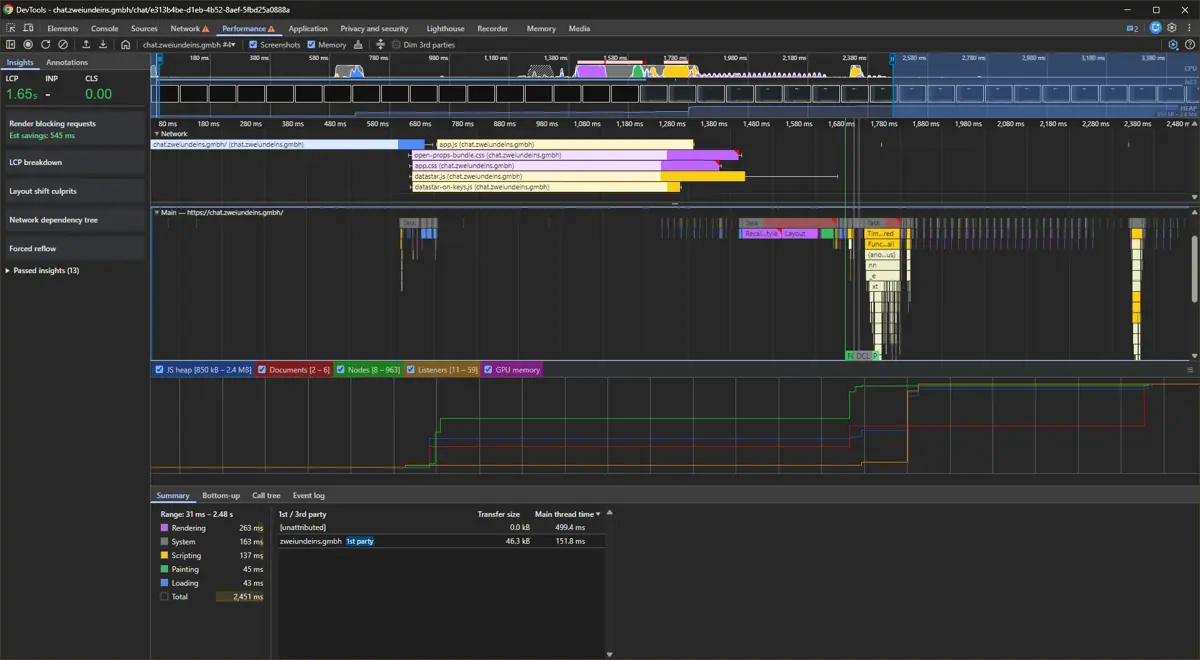
| Metrik | SPA | Hypermedia | Verhältnis |
|---|---|---|---|
| Largest Contentful Paint | 8.1 s | 1.1 s | 7.4× schneller |
| Gesamtzeit | 11.56 s | 2.45 s | 4.7× schneller |
| Scripting-Zeit | 5’613 ms | 257 ms | 21.8× weniger |
| Main-Thread-Zeit | 4’145 ms | 651 ms | 6.4× weniger |
| JS-Heap-Wachstum | +13.5 MB | +1.5 MB | 9× weniger |
| Übertragungsgrösse | ~1’107 KB | 41.9 KB | 26× weniger |
| DOM-Knoten, final | 326 | 963 | 3× mehr |
| Event Listeners | 349 | 59 | 5.9× weniger |
Der wichtigste visuelle Unterschied in den Flamegraphen: Die SPA zeigt hohe, dichte Stapel von JavaScript-Ausführung (gelbe Blöcke), die den Trace dominieren. Der Flamegraph von Hypermedia ist flach und spärlich: Der Grossteil der Zeit wird im Leerlauf oder mit nativem Browser-Rendering verbracht, nicht mit JavaScript-Ausführung. Hinweis: Scripting-Zeit und Main-Thread-Zeit stammen aus verschiedenen DevTools-Ansichten. Das Summary-Panel summiert sämtliche Script-Ausführungen über Threads hinweg (inkl. Workers), während die Main-Thread-Zeit die aggregierte Task-Dauer aus dem Activity-Tab ist. Beide überschneiden sich, decken aber nicht exakt denselben Scope ab, weshalb Scripting höher erscheinen kann als Main-Thread-Zeit.
Die höhere DOM-Knotenanzahl bei Hypermedia (963 vs. 326) spiegelt server-gerenderten Inhalt wider, der sofort sichtbar ist. Die SPA startet mit einem minimalen DOM und baut es clientseitig durch Hydration auf, weshalb sie trotz weniger Knoten 5.9× mehr Event Listener hat.
Chat-Antwort-Vergleich (Streaming)
Schieberegler ziehen, um SPA (links) vs. Hypermedia (rechts) zu vergleichen
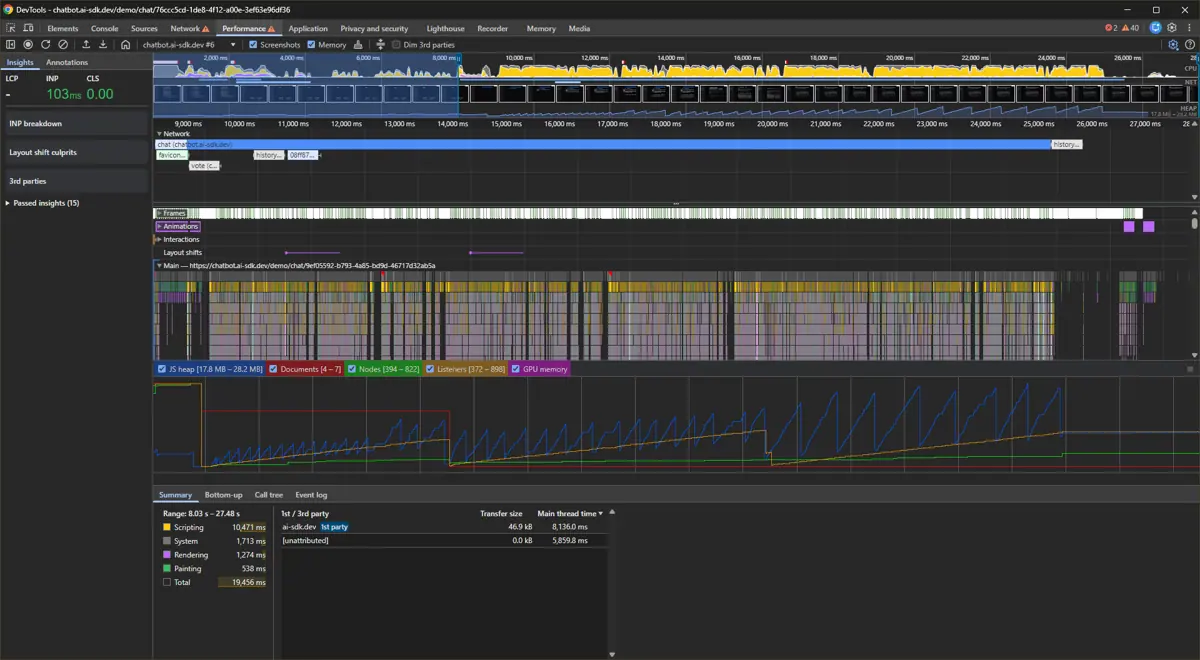
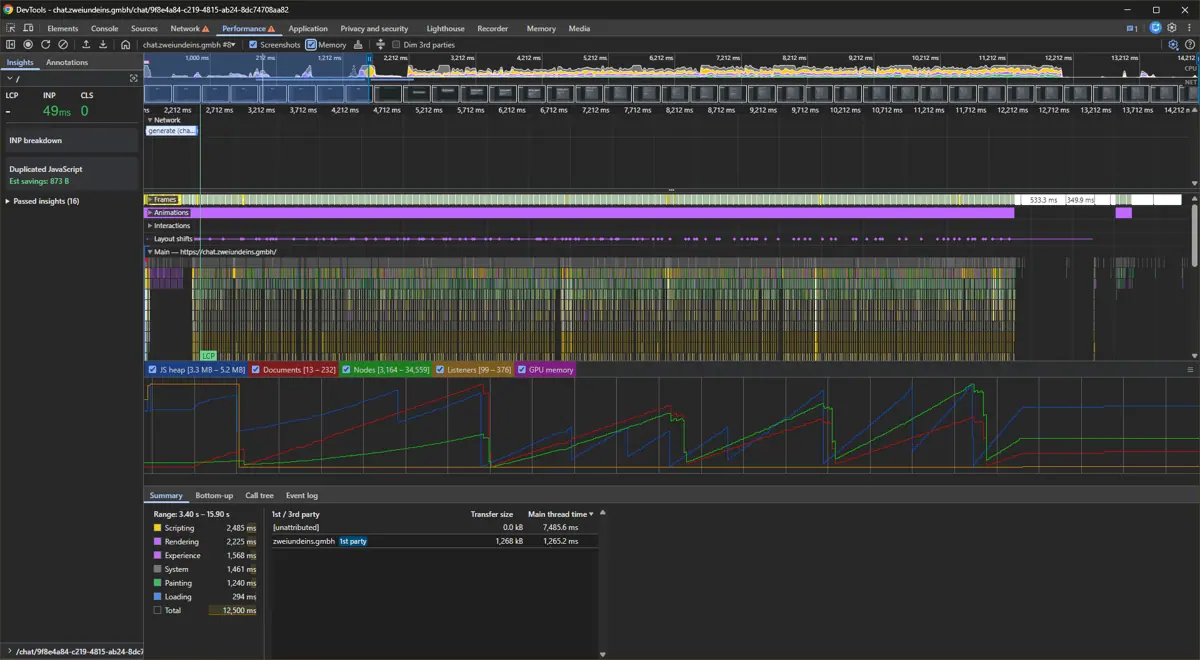
| Metrik | SPA | Hypermedia | Hinweise |
|---|---|---|---|
| LCP | 206 ms | 35 ms | 6× schneller |
| Scripting | 10’500 ms | 2’485 ms | 4.2× weniger JS-Arbeit |
| Rendering | 1’274 ms | 2’225 ms | Hypermedia patcht echtes DOM bei jedem Chunk |
| Painting | 538 ms | 1’240 ms | Mehr Paint = mehr DOM-Inhalt |
| Gesamt | 19’686 ms | 12’500 ms | 37% schneller gesamt |
| JS-Heap-Wachstum | +10.4 MB | +1.9 MB | 5.5× weniger Speicher |
| V8 Node Allocs ¹ | 394 → 822 | 3’164 → 34’559 | Hypermedia hoher GC-Druck; SPA moderates Wachstum |
Beim Streaming verbringt die SPA über 4× mehr Zeit mit JavaScript-Ausführung als die Hypermedia-Version (10’500 ms vs. 2’485 ms). Hypermedia kompensiert mit mehr Rendering- und Painting-Zeit, weil Datastar das echte DOM bei jedem eingehenden SSE-Chunk patcht, anstatt Updates in einem virtuellen DOM zu puffern. Der native HTML-Parser des Browsers übernimmt die Hauptarbeit, was als Rendering-Kosten statt Scripting-Kosten erscheint. Insgesamt schliesst Hypermedia den vollständigen Chat-Response-Zyklus 37% schneller ab (12’500 ms vs. 19’686 ms).
¹ V8 Node Allocs zählt alle Knoten im V8-Heap, angehängte und getrennte (ausstehende GC). Datastar ersetzt DOM-Patches bei jedem SSE-Event und erzeugt verwaiste Knoten, die sich bis zur Garbage Collection ansammeln; das Live-DOM nach dem Streaming ist ~400 bis 600 Knoten. React reconciliert meist In-place, sodass kaum getrennte Knoten entstehen (+428 vs. +31’395). Diese Metrik spiegelt GC-Druck, nicht Live-DOM-Grösse, wider.
Warum Speicher wichtig ist
Der 5.5-fache Unterschied beim Speicherwachstum (10.4 MB vs. 1.9 MB pro Chat-Interaktion) summiert sich mit der Zeit. Auf Mobilgeräten löst hoher Speicherdruck Garbage-Collection-Pausen aus, als UI-Ruckeln wahrnehmbar, das Nutzer als schlechte Performance empfinden. Jeder Ausschlag im Speicherdiagramm ist ein potenzieller Frame-Drop. Der React-Reconciliation-Overhead ist der Haupttreiber: Er hält einen Virtual-DOM-Baum im Speicher zusätzlich zum echten DOM vor, und dieser Overhead wächst mit jedem gestreamten Token.
Streaming-Effizienz: SSE-Kompression
KI-Chat in Echtzeit basiert auf Server-Sent Events (SSE) für Token-für-Token-Streaming. Die beiden Architekturen unterscheiden sich nicht nur bei der Kompression, sondern auch beim grundlegenden Verbindungsmodell: Hypermedia hält einen einzigen dauerhaften SSE-Stream für die gesamte Session offen, während die SPA für jede Nachrichtenrunde einen neuen Streaming-POST öffnet. Dieser Unterschied summiert sich stark über ein Gespräch: Nach 10 Runden erreicht Brotli auf einem dauerhaften Stream ein 58.5-faches Kompressionsverhältnis: Aus einem 29-fachen Rohdaten-Nachteil wird ein 2-facher Übertragungsvorteil. Die Zahlen in diesem Abschnitt stammen aus der Messung vom Februar.
Einzelne Runde (Claude 4.5 Haiku, gleicher Prompt)
| Metrik | SPA | Hypermedia | Hinweise |
|---|---|---|---|
| Endpoint-Modell | /chat (pro Anfrage) | /updates (dauerhaft) | |
| Kompression | Keine ² | Brotli | |
| Übertragen | 14.4 KB | 6.0 KB | 2.4× kleiner |
| Unkomprimiert | 14.4 KB | 112 KB | Hypermedia streamt bei naiver Implementierung pro Token das vollständige Fragment erneut |
| Kompressionsverhältnis | 1× | 18.7× |
Gespräch über mehrere Runden (10 Runden, identische Prompts)
| Metrik | SPA | Hypermedia | Hinweise |
|---|---|---|---|
| SSE-Verbindungen | 10 (eine pro Runde) | 1 (dauerhaft) | Hypermedia nutzt einen offenen Stream wieder |
| Kompression | Keine ² | Brotli 58.5× | Rundenübergreifende Wiederholungen erhöhen das Verhältnis |
| Übertragen (Streaming) | ~114 KB | 55.8 KB | 2× weniger |
| Unkomprimiert (Streaming) | ~114 KB | 3’265 KB | Naive Implementierung streamt bei jedem Token das vollständige Fragment erneut |
58.5× Brotli-Kompressionsverhältnis nach 10 Runden auf einem dauerhaften SSE-Stream
Es lohnt sich, ehrlich zu sein, was unsere PHP-Implementierung im Februar tatsächlich tat: Jedes Mal, wenn die KI ein neues Wort ausgab, wurde das gesamte Nachrichten-HTML-Fragment von vorne gestreamt, nicht nur das neue Token. Jeder Chunk ersetzte den vorherigen vollständig. Das war eine bewusste Einfachheitsentscheidung, keine Datastar-Anforderung: den naiven Ansatz wählen, bis es einen Grund gibt, es anders zu machen. Das erklärt das 29-fache Rohdaten-Gefälle. Trotz dieser selbst auferlegten Ineffizienz schlug die Kombination aus Brotli auf einer dauerhaften Verbindung die SPA über 10 Runden. Die Kompression glich mehr aus, als die naive Implementierung kostete.
Seit dem Umstieg auf php-via schickt die App weiterhin das ganze Fragment, aber höchstens 20-mal pro Sekunde statt bei jedem Token. Zehn Runden mit einer Antwort von 1’091 Zeichen kosten jetzt 34.5 KB über die Leitung (2.5 MB vor der Kompression); nach der ersten Runde braucht jede weitere etwa 2 KB.
Der Vorteil bei einer einzelnen Runde (2.4×) ist bereits vorhanden: Brotlis 18.7-faches Kompressionsverhältnis verwandelt einen 7.8-fachen Rohdaten-Nachteil in einen Nettogewinn. Der Vorteil über mehrere Runden wächst weiter: Ein dauerhafter Stream lässt Brotli alle Runden gemeinsam komprimieren und nutzt die rundenübergreifende Wiederholung im Chat-HTML, das mit wachsendem Gespräch zunimmt. Nach 10 Runden überträgt Hypermedia halb so viele Daten wie die SPA, selbst ausgehend von einer Implementierung, die vor der Kompression 29× mehr Bandbreite verschwendet.
² Next.js Streaming-POST-Antworten (/chat) haben keinen Content-Encoding-Header. Das Aktivieren von Komprimierungs-Middleware auf der Streaming-Route würde diese Lücke teilweise schliessen, aber der Overhead pro Verbindungsaufbau und die Unfähigkeit, ein Brotli-Wörterbuch über Runden hinweg zu teilen, würden bestehen bleiben.
Codebase- & Betriebskomplexität
| Metrik | SPA | Hypermedia | Hinweise |
|---|---|---|---|
| Abhängigkeiten (Produktion) | 592 | 18 | 33× weniger |
| Speicher (node_modules/vendor) | 714 MB | 4.6 MB | 155× kleiner |
| Build-Schritt erforderlich | Ja | Nein | |
| Cold Start | 1.85 s (Januar) | 0 ms | Kein Serverless-Penalty |
| Lasttest (10 Nutzer, ein Worker) | Rate-Limit | 298 Anfragen/s | Februar: 44 Anfragen/s |
| Hosting | Vercel (nutzungsbasiert) | 20 $/Jahr VPS | Planbare Kosten |
Weniger Abhängigkeiten bedeuten eine kleinere Angriffsfläche, einfachere Sicherheitsaudits und weniger Breaking Changes beim Upgraden. Die 155-fache Reduktion des Produktions-Speicherplatzes führt auch zu schnelleren CI/CD-Pipelines und einfacheren Container-Images.
Die Wirtschaftlichkeit der Einfachheit
Technische Metriken sind interessant, aber was bedeuten sie für das Business? Architekturentscheidungen wirken sich über die Zeit aus und beeinflussen nicht nur die Performance, sondern auch die Entwicklungsgeschwindigkeit, Betriebskosten und Teamproduktivität.
Features vs. Wartung: Wohin geht die Zeit?
Überlegen Sie, was 592 Produktionsabhängigkeiten in der Praxis bedeuten. Jede Abhängigkeit ist eine potenzielle Quelle für Sicherheitslücken, die gepatcht werden müssen, Breaking Changes, die berücksichtigt werden müssen, und Kompatibilitätsprobleme, die debuggt werden müssen. Mit den schnellen Release-Zyklen im JavaScript-Ökosystem fliesst ein erheblicher Teil der Entwicklungszeit in die Pflege des Abhängigkeitsbaums statt ins Feature-Building.
33×
weniger Abhängigkeiten zum Auditieren, Aktualisieren und Absichern
0
Build-Schritte ermöglichen schnellere Iteration und einfachere Deployments
20 $/Jahr
planbare Hosting-Kosten statt nutzungsbasierter Überraschungen
Die versteckten Kosten der Komplexität
Komplexe Architekturen verlangsamen nicht nur die Anwendung, sondern auch das Team. Jede Architekturschicht erhöht die kognitive Last: Entwickler müssen Reacts Reconciliation, Next.js Rendering-Modi, das Vercel-Deployment-Modell und die Interaktion zwischen Client- und Server-State verstehen. Dieses Wissen braucht Zeit zum Aufbau und zur Pflege.
Im Gegensatz dazu hat eine server-autoritäre Hypermedia-Architektur eine einzige Quelle der Wahrheit (der Server), einen Rendering-Ort (der Server) und ein Deployment-Ziel (ein einfacher Prozess). Neue Teammitglieder werden schneller produktiv, und Debugging folgt einem einfachen Request-Response-Modell, statt State durch mehrere Schichten zu verfolgen.
Total Cost of Ownership
Bei der Architekturbewertung das Gesamtbild berücksichtigen:
- Entwicklungskosten: Wie viel Zeit für framework-spezifische Probleme vs. Business-Logik? Wie lange dauert das Onboarding?
- Infrastrukturkosten: Wie hoch ist die monatliche Rechnung? Wie planbar ist sie? Was passiert bei Traffic-Spitzen?
- Opportunitätskosten: Welche Features hätten mit der Zeit gebaut werden können, die für Abhängigkeits-Upgrades und Build-Pipeline-Wartung aufgewendet wurde?
- Risikokosten: Wie gross ist die Angriffsfläche? Wie schnell können Sicherheits-Patches ausgerollt werden?
Wann sich Einfachheit auszahlt
Das wirtschaftliche Argument für reduzierte Komplexität ist am stärksten dort, wo Zeit und Geld begrenzt sind, also in den meisten Projekten. Ein kleines Team ohne eigenen DevOps-Engineer oder Frontend-Spezialisten kann es sich schlicht nicht leisten, einen 592-Abhängigkeiten-Graph zu betreuen. Wenn ein transitives Paket ein Breaking Change einführt, ist das keine abstrakte Unannehmlichkeit; es ist ein halber Tag ungeplanter Arbeit, der ein Feature verdrängt. Je schlanker der Abhängigkeitsbaum, desto seltener passiert das.
Bei Anwendungen, die eher Jahre als Monate laufen sollen, wird diese Dynamik noch ausgeprägter. Initiale Entwicklungskosten sind eine Einmalzahlung, aber Wartung kumuliert sich unbegrenzt. Jedes Major-Framework-Upgrade, jede veraltete API, jede Verschiebung im JavaScript-Ökosystem kommt zum laufenden Gesamtaufwand hinzu. Weniger Abhängigkeiten und ein einfacheres mentales Modell halten diese Kosten beherrschbar, und institutionelles Wissen bleibt länger relevant.
Die Hosting-Wirtschaftlichkeit folgt derselben Logik. Nutzungsbasierte Preisgestaltung fängt zwar eine moderate Traffic-Spitze auf, bringt aber eine Abrechnungsüberraschung mit sich, die eine ungeplante Architekturüberprüfung erzwingt. Ein planbarer VPS für 20 $/Jahr tut das nicht. Die Kosten sind im Voraus bekannt, skalieren mit dem Team-Budget und halten den Fokus auf dem Produkt statt auf Cloud-Spending-Dashboards.
Schliesslich steht das Publikum selbst im Mittelpunkt. Die vollständige Eliminierung der Blocking Time (0 ms vs. 898 ms) und die 8.3-fache Verbesserung der Time to Interactive sind keine Benchmark-Kuriositäten: Sie entscheiden darüber, ob ein Nutzer auf einem Mittelklasse-Smartphone mit instabiler Verbindung das Produkt tatsächlich nutzen kann oder es in den ersten zehn Sekunden abbricht.
Einschränkungen & Vorbehalte
Was dieser Artikel nicht abdeckt
- Hardware-Spezifität: Tests wurden auf spezifischer Hardware durchgeführt (Februar: AMD Ryzen 7 Pro 7840U, Oktober: Intel Core i5-13500; Mobile emuliert). Ergebnisse können auf anderen Geräten abweichen.
- Netzwerk-Emulation: Chromes Slow-4G-Drosselung simuliert, repliziert aber keine echten Mobilfunkbedingungen mit Paketverlust und Jitter.
- Inhaltstypen: Dieser Vergleich konzentriert sich auf eine KI-Chat-Anwendung. Performance-Charakteristika können sich bei anderen Inhaltstypen (E-Commerce, Dashboards usw.) unterscheiden.
- Team-Expertise: Entwickler mit SPA-Hintergrund müssen clientseitige State-Management-Muster verlernen und server-autoritäres Denken annehmen, ein mentaler Wandel, der Zeit braucht.
- Ökosystem-Reife: Das React/Next.js-Ökosystem hat mehr Tutorials, Stack-Overflow-Antworten und verfügbare Entwickler als Hypermedia-Ansätze.
- Benchmarking ist schwierig: Aussagekräftige Performance-Messungen sind von Natur aus komplex. Ergebnisse variieren zwischen Durchläufen, Drosselungsprofile approximieren reale Bedingungen nur, und kleine methodische Entscheidungen (Cache-Zustand, Viewport-Grösse, Netzwerkprofil) können die Zahlen merklich verschieben. KI-Anwendungen bringen eine zusätzliche Variabilitätsebene mit: Keine zwei LLM-Antworten sind in Länge oder Timing identisch, was Streaming-Benchmarks besonders schwer exakt reproduzierbar macht. Die Verhältnisse sind als Richtungswerte zu verstehen, nicht als absolute Grössen.
- Feature-Vollständigkeit: Der PHP-Port ist ein funktionierender Proof-of-Concept. Einige Features (Dateianhänge, Bearbeiten/Regenerieren) sind nicht implementiert.
Wann was wählen
Architekturentscheidungen sollten von Anforderungen getrieben werden, nicht von Trends. Hier ist ein Rahmen zum Nachdenken über die Abwägungen:
Hypermedia in Betracht ziehen bei:
- Inhaltsreichen Anwendungen (Dokumente, Artikel, Dashboards)
- SEO-Relevanz für das Geschäft
- Globalem Publikum mit unterschiedlichen Netzwerkbedingungen
- Echtzeit-Streaming als Kernfunktion
- Planbaren Hosting-Kosten
- Backend-Expertise im Team
- Fokus auf langfristige Wartbarkeit
- Minimierung der Sicherheits-Angriffsfläche
SPA in Betracht ziehen bei:
- Offline-first als hartes Requirement
- Schwerem clientseitigem Computing (Bild-/Videobearbeitung, CAD)
- Komplexen Drag-&-Drop- oder Canvas-Interaktionen
- Bestehendem React-Team mit etablierten Patterns
- Integration mit React Native für Mobile Apps
- Kritischer Bedeutung des Third-Party-Komponentenökosystems
- Nutzern mit konstant schnellen Verbindungen
Viele Anwendungen brauchen die Komplexität einer vollständigen SPA nicht. Die Frage ist nicht «was ist besser», sondern «welche Abwägungen passen zu meinen Rahmenbedingungen».
Zusammenfassung
| Kategorie | Gewinner | Kennzahl |
|---|---|---|
| Mobile Performance Score | Hypermedia | 100 vs. 52 |
| Time to Interactive (Mobile) | Hypermedia | 1.07 s vs. 8.87 s (8.3×) |
| Total Blocking Time (Mobile) | Hypermedia | 0 ms vs. 898 ms (eliminiert) |
| Seitengewicht | Hypermedia | 52 KB vs. 1.4 MB (27×) |
| JavaScript-Bundle | Hypermedia | 13.6 KB vs. 1.3 MB (95×) |
| JS-Ausführungszeit (Laden) | Hypermedia | 257 ms vs. 5’613 ms (21.8×, Februar) |
| Speicher pro Interaktion | Hypermedia | +1.9 MB vs. +10.4 MB (5.5×, Februar) |
| SSE-Kompression | Hypermedia | Brotli 58.5× vs. keine; 2× weniger übertragen über 10 Runden (Februar) |
| Abhängigkeiten (Prod.) | Hypermedia | 18 vs. 592 (33×) |
Hypermedia gewinnt alle 9 gemessenen Kategorien eindeutig.
Diese Ergebnisse bedeuten nicht, dass SPAs «schlecht» sind oder dass jede Anwendung Hypermedia nutzen sollte. Sie zeigen, dass die Standardwahl einer SPA-Architektur reale Kosten trägt, die unter eingeschränkten Bedingungen erheblich werden, und dass Alternativen existieren.
Rohdaten: GitHub-Repository
Alle Benchmark-Daten, Lighthouse-Reports und Chrome-DevTools-Traces stehen zur unabhängigen Verifizierung zur Verfügung.